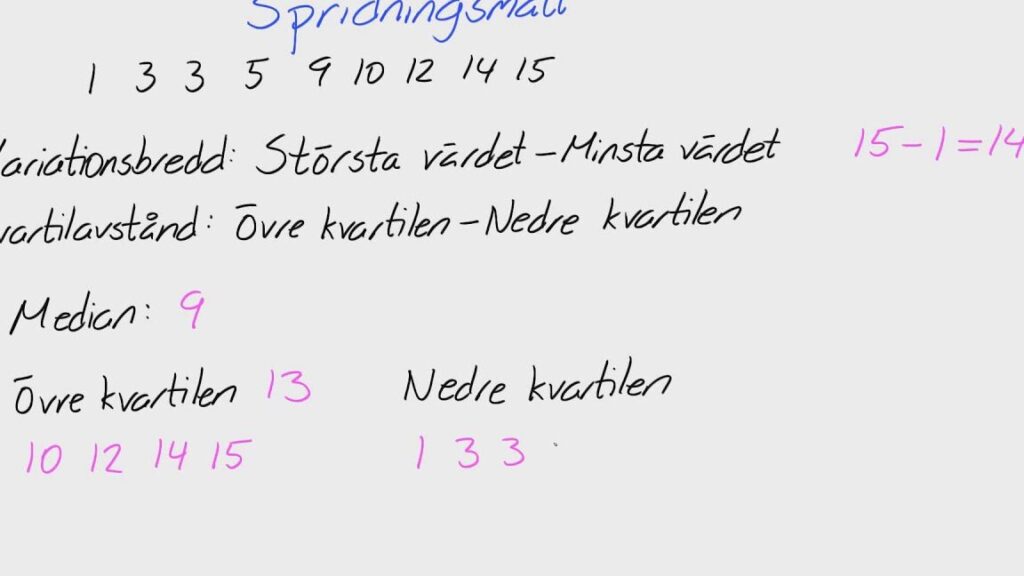
Spridningsmått är avgörande för att förstå data och dess variation. I statistik använder vi spridningsmått exempel för att analysera hur mycket värden i en dataset avviker från medelvärdet. Genom att använda dessa mått kan vi få en tydligare bild av mönster och trender som kanske inte framgår vid första anblick.
Vi kommer att utforska olika spridningsmått som standardavvikelse, varians och kvartiler. Varje exempel hjälper oss att se hur dessa verktyg tillämpas i praktiska situationer inom statistik. Att känna till spridningsmått exempel är nödvändigt för alla som arbetar med dataanalys eller forskar.
Är ni redo att dyka djupare in i världen av spridningsmått? Låt oss tillsammans upptäcka deras betydelse och hur de kan förbättra vår förståelse av statistiska resultat!
Spridningsmått Exempel och Deras Betydelse i Statistik
Spridningsmått är centrala verktyg inom statistik som hjälper oss att förstå hur data fördelar sig kring ett medelvärde. Genom att analysera spridningen kan vi identifiera mönster, avvikelser och variationer i våra datamängder. Det är viktigt att notera att spridningsmått inte bara ger oss en siffra, utan också insikter om den underliggande datan och dess potentiella påverkan på våra analyser.
Varför Spridningsmått är Viktiga
Att använda spridningsmått exempelvis varians och standardavvikelse gör det möjligt för oss att få en djupare förståelse av hur mycket värdena varierar från medelvärdet. Detta är särskilt användbart när vi jämför olika dataset eller försöker dra slutsatser baserade på statistiska analyser. Här är några anledningar till deras betydelse:
- Identifiering av Avvikelser: Spridningsmåtten gör det enklare att se om vissa observationer står ut från resten.
- Jämförelse mellan Dataset: Vi kan lättare avgöra vilket dataset som har mer variation.
- Beslutsfattande: Genom att förstå spridningen kan vi fatta mer informerade beslut baserat på risk och osäkerhet.
Tillämpningar av Spridningsmått
Spridningsmått används inom många områden, inklusive:
- Forskning: För att analysera resultatens tillförlitlighet.
- Ekonomi: Vid bedömning av finansiella risker.
- Hälsovetenskap: För studier kring effekten av behandlingar där variationen i resultaten spelar en stor roll.
Genom dessa tillämpningar får vi en bättre bild av de faktorer som påverkar vår analys och kan anpassa våra metoder därefter.
| Spridningsmått | Definition | Användning |
|---|---|---|
| Varians | Måttet på hur mycket värdena skiljer sig från medelvärdet. | Förstå datats spridning. |
| Standardavvikelse | Roten ur variansen; visar genomsnittlig skillnad från medelvärdet. | Kvantifiera osäkerheten i prognoser. |
| IQR (Interkvartilavstånd) | Differensen mellan tredje kvartilen (Q3) och första kvartilen (Q1). | Mäter spriddheten hos de mittersta 50% av data. |
Att bemästra användningen av dessa mått ger oss verktygen för effektiv dataanalys, vilket leder till mer precisa resultat i vårt arbete – oavsett vilket område vi verkar inom.
Typer av Spridningsmått och Deras Användning
Det finns flera typer av spridningsmått som används för att beskriva hur data varierar. Varje mått har sina specifika användningsområden och ger olika insikter om datamängderna. Nedan går vi igenom de mest använda spridningsmåtten samt deras praktiska tillämpningar.
Varians
Variansen är ett grundläggande spridningsmått som mäter hur mycket värdena i en dataset skiljer sig från medelvärdet. Genom att beräkna variansen kan vi få en uppfattning om den övergripande variationen inom datan.
- Användning: I forskning används varians för att bedöma resultaten av experiment, där hög varians kan indikera osäkerhet eller oförutsägbarhet i resultaten.
Standardavvikelse
Standardavvikelsen är roten ur variansen och ger oss en mer intuitiv förståelse av spridningen genom att uttrycka den i samma enheter som originaldata. Detta gör det enklare att tolka skillnader och varianser mellan olika dataset.
- Användning: Inom ekonomi används standardavvikelsen för riskbedömningar, där investerare analyserar volatiliteten hos aktier eller andra finansiella instrument.
Interkvartilavstånd (IQR)
Interkvartilavståndet (IQR) representerar skillnaden mellan tredje kvartilen (Q3) och första kvartilen (Q1). Detta mått fokuserar på de mittersta 50 % av data, vilket gör det mindre känsligt för extremvärden jämfört med varians och standardavvikelse.
- Användning: IQR används ofta inom hälsovetenskap när man analyserar resultat från kliniska studier, där forskare vill förstå hur behandlingarna påverkar majoriteten av deltagarna utan inverkan från uteliggare.
| Spridningsmått | Definition | Användning |
|---|---|---|
| Varians | Måttet på hur mycket värdena skiljer sig från medelvärdet. | Bedömning av resultatens tillförlitlighet. |
| Standardavvikelse | Roten ur variansen; visar genomsnittlig skillnad från medelvärdet. | Kvantifiering av risk och osäkerhet. |
| IQR (Interkvartilavstånd) | Differensen mellan tredje kvartilen (Q3) och första kvartilen (Q1). | Mätning av spriddheten hos de mittersta 50% av data. |
Att välja rätt typ av spridningsmått beror på syftet med vår analys och vilken typ av data vi arbetar med. Genom att kombinera dessa olika mått kan vi få en mer omfattande bild av datats struktur och dess variationer, vilket hjälper oss i våra beslutsprocesser oavsett område.
Praktiska Exempel på Spridningsmått i Forskning
I forskningssammanhang spelar spridningsmått en avgörande roll för att förstå och tolka data. Genom konkreta exempel kan vi se hur dessa mått tillämpas i olika discipliner, vilket belyser deras betydelse. Nedan presenteras några praktiska exempel på hur spridningsmått används inom forskning.
### Exempel 1: Hälsoforskning
Inom hälsoforskning är det vanligt att använda standardavvikelse för att mäta variationen i patienters svar på behandlingar. Till exempel, när en studie undersöker effekten av ett nytt läkemedel mot högt blodtryck, kan forskarna beräkna standardavvikelsen av blodtrycksminskningen bland deltagarna. En låg standardavvikelse indikerar att de flesta patienter svarade liknande på behandlingen, medan en hög standardavvikelse tyder på varierande resultat.
### Exempel 2: Utbildning
Inom utbildningssektorn kan interkvartilavståndet (IQR) användas för att analysera testresultat bland studenter. Genom att fokusera på IQR får vi en tydlig bild av prestationen hos den centrala delen av studenterna utan påverkan från extremvärden, såsom elever med anmärkningsvärt låga eller höga betyg. Detta ger lärare och skoladministratörer insikter om hur majoriteten presterar och var det finns behov av stödåtgärder.
### Exempel 3: Marknadsundersökningar
Variansen är ett annat viktigt spridningsmått som används vid marknadsundersökningar för att bedöma kundnöjdhet. Om en företag genomför en enkät om sin tjänst kan variansen hjälpa dem förstå hur mycket åsikterna skiljer sig åt bland kunderna. En hög varians kan signalera behovet av förändringar eller förbättringar i tjänsten för att möta kundernas krav bättre.
| Spridningsmått | Användning | Exempel |
|---|---|---|
| Standardavvikelse | Mäta variationen i patienters respons. | Effekt av läkemedel mot högt blodtryck. |
| IQR (Interkvartilavstånd) | Analysera prestationer bland studenter. | Tentamensresultat utan påverkan från extremvärden. |
| Varians | Betygsätta kundnöjdhet. | Kundundersökningar inom företag. |
Dessa exempel visar tydligt hur spridningsmått inte bara är teoretiska koncept utan verktyg som hjälper oss göra informerade beslut baserat på dataanalys inom flera områden. Genom att använda rätt spridningsmått får vi djupare insikter och bättre förståelse för våra datamängder, oavsett om det handlar om hälsa, utbildning eller marknadstrender.
Hur Man Tillämpa Spridningsmått i Dataanalys
Att tillämpa spridningsmått i dataanalys är en grundläggande färdighet för forskare och analytiker. Genom att förstå hur dessa mått fungerar kan vi få en djupare insikt i våra datamängder och därmed fatta välgrundade beslut. Spridningsmått, såsom standardavvikelse, varians och interkvartilavstånd, ger oss verktyg för att beskriva variationen inom vår data. Här nedan följer några praktiska sätt som vi kan använda spridningsmått i vår analys.
### Tillämpning av Standardavvikelse
Standardavvikelsen är ett av de mest använda spridningsmåtten och hjälper oss att mäta hur mycket värdena varierar från medelvärdet. I praktiken innebär detta att vi kan identifiera om våra data är koncentrerade kring ett centralt värde eller om det finns stor variation. Vi kan exempelvis beräkna standardavvikelsen för resultaten av ett experiment för att se hur stabilt resultatet är över tid. En låg standardavvikelse indikerar konsekventa resultat, medan en hög standardavvikelse antyder osäkerhet.
### Variansens Roll
Variansen används också flitigt inom olika områden av dataanalys. Den representerar den genomsnittliga kvadraten av avvikelser från medelvärdet och erbjuder en viktig inblick när vi analyserar dataset med många observationer. Genom att beräkna variansen kan vi upptäcka mönster eller anomalier i datan som annars skulle kunna förbises. Detta är särskilt användbart vid utveckling av produkter eller tjänster där förståelse för kundernas beteende och preferenser är avgörande.
### Interkvartilavståndets Fördelar
Interkvartilavståndet (IQR) ger oss information om spridningen bland de mittersta 50 procenten av våra data. Det har den stora fördelen att det inte påverkas lika mycket av extremvärden jämfört med andra spridningsmått som standardavvikelse och varians. Genom att fokusera på IQR får vi mer robusta insikter när vi analyserar testresultat eller kunddata där ytterligheter kan snedvrida tolkningen.
| Spridningsmått | Användning | Exempel |
|---|---|---|
| Standardavvikelse | Mäta variationen kring medelvärdet. | Konsistens i experimentresultat. |
| Varians | Betygsätta skillnader mellan observationer. | Analysera kundbeteenden. |
| IQR (Interkvartilavstånd) | Fokusera på centrala tendenser utan påverkan från extremvärden. | Tentamensresultat bland studenter. |
Genom dessa tillämpningar ser vi tydligt hur spridningsmått inte bara är teoretiska begrepp utan praktiska verktyg som underlättar vår förståelse och insikter inom dataanalys. När vi väljer rätt spridningsmått anpassat efter vårt specifika sammanhang får vi möjlighet till djupgående analyser vilket leder till bättre informerade beslut baserat på evidens snarare än antaganden.
Vanliga Misstag vid Tolkning av Spridningsmått
Vid tolkning av spridningsmått är det viktigt att vara medveten om vanliga misstag som kan leda till felaktiga slutsatser. Många analytiker, särskilt de som är nya inom statistik, riskerar att övergeneralisera resultaten eller att bortse från specifika kontexter där spridningsmåtten tillämpas. Genom att förstå dessa fallgropar kan vi förbättra vår dataanalys och fatta mer informerade beslut.
### Överbetoning på Standardavvikelse
Ett vanligt misstag är att enbart förlita sig på standardavvikelsen för att bedöma variationen i data. Även om den är ett kraftfullt verktyg, kan den ge en missvisande bild när datamängden innehåller extremvärden eller outliers. I sådana fall kan interkvartilavståndet (IQR) erbjuda en mer nyanserad bild av spridningen genom att fokusera på de centrala värdena.
### Felaktig Tolkning av Varians
Variansen, trots sin användbarhet, misstolkas ofta. Många tror kanske att ju högre varians, desto större osäkerhet – vilket inte alltid stämmer. Det är avgörande att förstå vad variansen representerar och hur den relaterar till medelvärdet samt andra mått. Till exempel kan en hög varians indikera stor spridning men också variera beroende på datakällan och dess natur.
### Ignorera Kontexten
Kontextuella faktorer spelar en betydande roll vid tolkning av spridningsmått. Vi måste anpassa våra analyser efter den specifika situationen eller datasetet vi arbetar med. Ett spridningsmått som fungerar bra i ett sammanhang kanske inte ger samma insikter i ett annat. Därför bör vi alltid fråga oss vilka faktorer som påverkar våra resultat innan vi drar några slutsatser.
| Misstag | Beskrivning | Korrigering |
|---|---|---|
| Överbetoning på standardavvikelse | Bara använda standardavvikelse utan hänsyn till outliers. | Använd IQR för mer robust analys. |
| Felaktig tolkning av varians | Tro att hög varians alltid innebär osäkerhet. | Analysera relationer mellan varians och medelvärde. |
| Ignorera kontexten | Dra slutsatser utan hänsyn till datakällor. | Anpassa analys efter specifik situation. |
Genom att vara medvetna om dessa kan vi öka noggrannheten i vår dataanalys och säkerställa mer relevanta och exakta resultat. Att kritiskt granska våra metoder och antaganden hjälper oss skapa bättre insikter baserat på evidens snarare än osäkra antaganden.